LibTV Free:本地免费把 AI 素材拼成「电影」的全流水线
LibTV Free:本地免费把 AI 素材拼成「电影」的全流水线
一句话:把文字脚本,变成带拟真配音、数字人出镜、电影级调色的成片 MP4——配音、出镜、调色、渲染全程本地,零调用费。
AI 视频最大的坑有两个:一是按秒计费,试错成本居高不下;二是素材拼起来像 PPT,17 秒一个不动的镜头,调色再狠也救不回来。
LibTV Free 就是冲这两点做的:一条从脚本到成片的本地流水线,外加一套把「幻灯片」掰回「电影」的结构化工具。下面分三块讲——能干什么(功能)、怎么真跑(实战)、踩完一遍的结论。
TL;DR 配音、数字人、调色、渲染全程本地免费;电影感靠结构不靠滤镜;响度归一在编码前做;1:1 克隆与顶级「照片说话」仍需上云。
一、功能总览
| 模块 | 能干嘛 | 本地? | 要钱吗 |
|---|---|---|---|
| 拟真配音 | 文字台词 → 神经网络语音(云扬/云健/云希/晓晓… + 东北/陕西方言),可换情绪 | ✅ 服务起在本机 | 默认 Edge 免费;Azure/Fish 需自备 key |
| 数字人出镜 | 一张正脸图 + 台词 → 嘴型跟台词动的口播视频;视线矫正 | ✅ 双引擎本地跑通 | 不要 |
| 电影化管线 | LUT 调色 + 慢动作 + 2.39:1 遮幅 + 无底板字幕 | ✅ 全 ffmpeg/脚本 | 不要 |
| 渲染成片 | 浏览器写分镜 → 一键出 MP4,响度自动归一 | ✅ | 不要 |
| 资产链 | 角色锁脸 + 场景/道具/镜头 schema,保证多镜头一致 | ✅ | 不要 |
配音、数字人、调色、渲染、资产链全部本地跑、不按次计费,模型权重装好一次反复用。唯一可能花钱的是云端 AI 出图/出片(ImageGen / VideoGen 按量计费)——用自备素材或本地生成,那一环也归零。
二、五大功能详解
1. 拟真配音:先解决「浏览器连不上」这件事
浏览器里直接连 Edge 语音一律被 403 拒绝(服务端校验 Origin,页面改不了自己的 Origin);
本机 speechSynthesis 只有 Win7 时代的机械音。解法:把语音合成放在本地进程,页面走 HTTP 取音频。
1 | |
- 默认 Edge 免费神经网络语音,情绪是声学模拟(语速/音高/音量/滤波组合)。
- 想要模型自己「演」出来的真神经情感,把
.env.example复制成.env填一段即可:AZURE_SPEECH_KEY+AZURE_SPEECH_REGION→<mstts:express-as>真情感FISH_API_KEY+FISH_REFERENCE_ID→ 中文表现力好LOCAL_TTS_URL→ 自起 CosyVoice2 / GPT-SoVITS,零调用费、可离线
- 后端自动选:就绪的真神经优先,都没有退 Edge;
TTS_BACKEND可锁定,配坏也会自动回落。
2. 数字人出镜:两个引擎,不是替代关系
| 引擎 | 定位 | 实测 | 适合 |
|---|---|---|---|
SadTalker(--quality high,默认) |
质量优先 | 3DMM 表情 + 头部姿态 + 眨眼;RTX 4060 约 1 分 21 秒/成片 | 近景口播、要像真人 |
Wav2Lip(--quality fast) |
速度优先 | 只换嘴部 96×96;5 秒台词约 13 秒出片 | 远景、快速试稿 |
1 | |
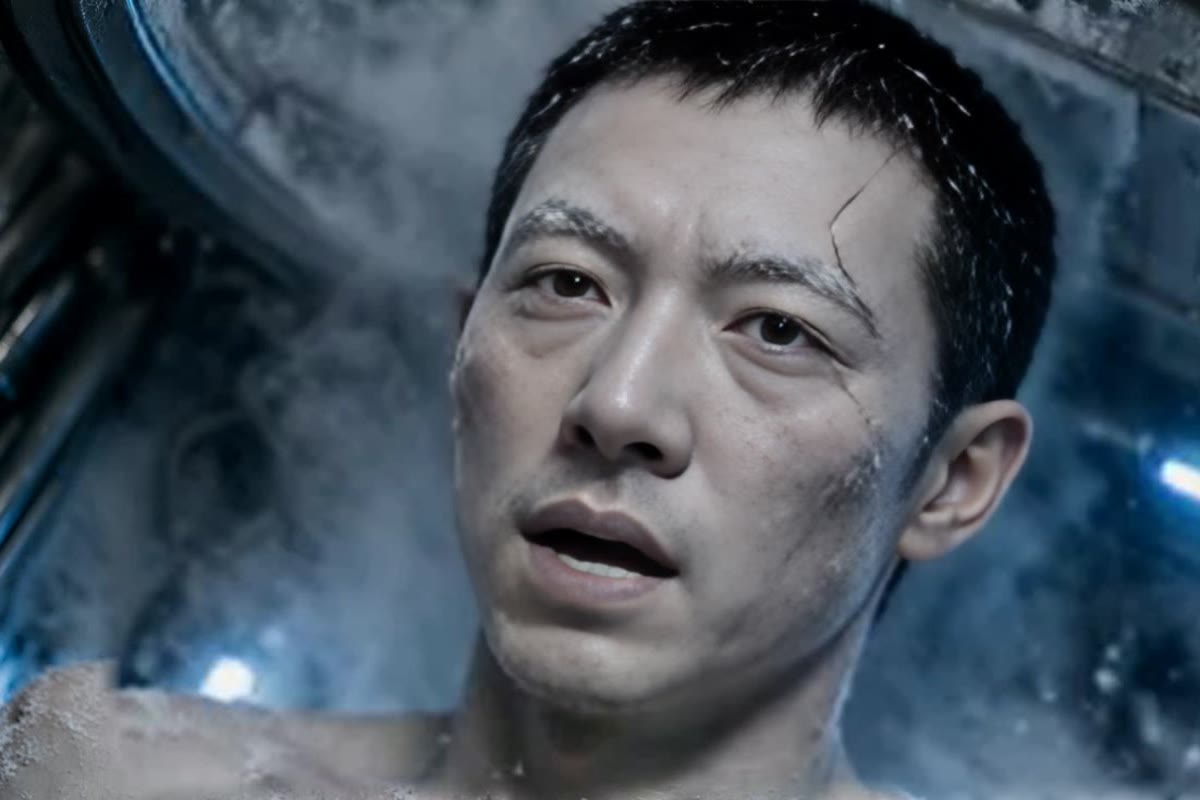
本地 SadTalker 实拍帧:正脸、张嘴说话中,会眨眼点头——这就是「质量优先」那档的效果。
另有 eye-contact 视线矫正(画面级补偿,无需外部服务),以及待接 AK/SK 的即梦/BiBigModel 云端 provider 骨架。
3. 电影化管线:电影感 = 4 维度,不是滤镜
「像不像电影」是结构问题,不是滤镜问题。原版《第 3001 次日出》247 秒只有 14 个镜头(平均 17.6 秒/镜),
直接就是 PPT。改造后 68 个镜头、平均 3.52 秒/镜,才像电影。
四个维度可勾选一键跑(tools/cinema-pack.js):
- 画面质感 —
make-lut.js生成胶片 S 曲线 LUT,grade-assets.js烘焙进全部素材(调色放 conform 阶段,不在渲染时逐帧查表)。 - 宽银幕画幅 — 2.39:1 真裁宽(上下 138px 遮幅),不是假黑边。
- 慢动作节奏 —
slowmo.js光流插值;必须先setpts定时长、再minterpolate补帧,反过来会丢帧。 - 电影级音效 — 环境音床 + 低频 + 响度归一(详见「4. 渲染成片」)。
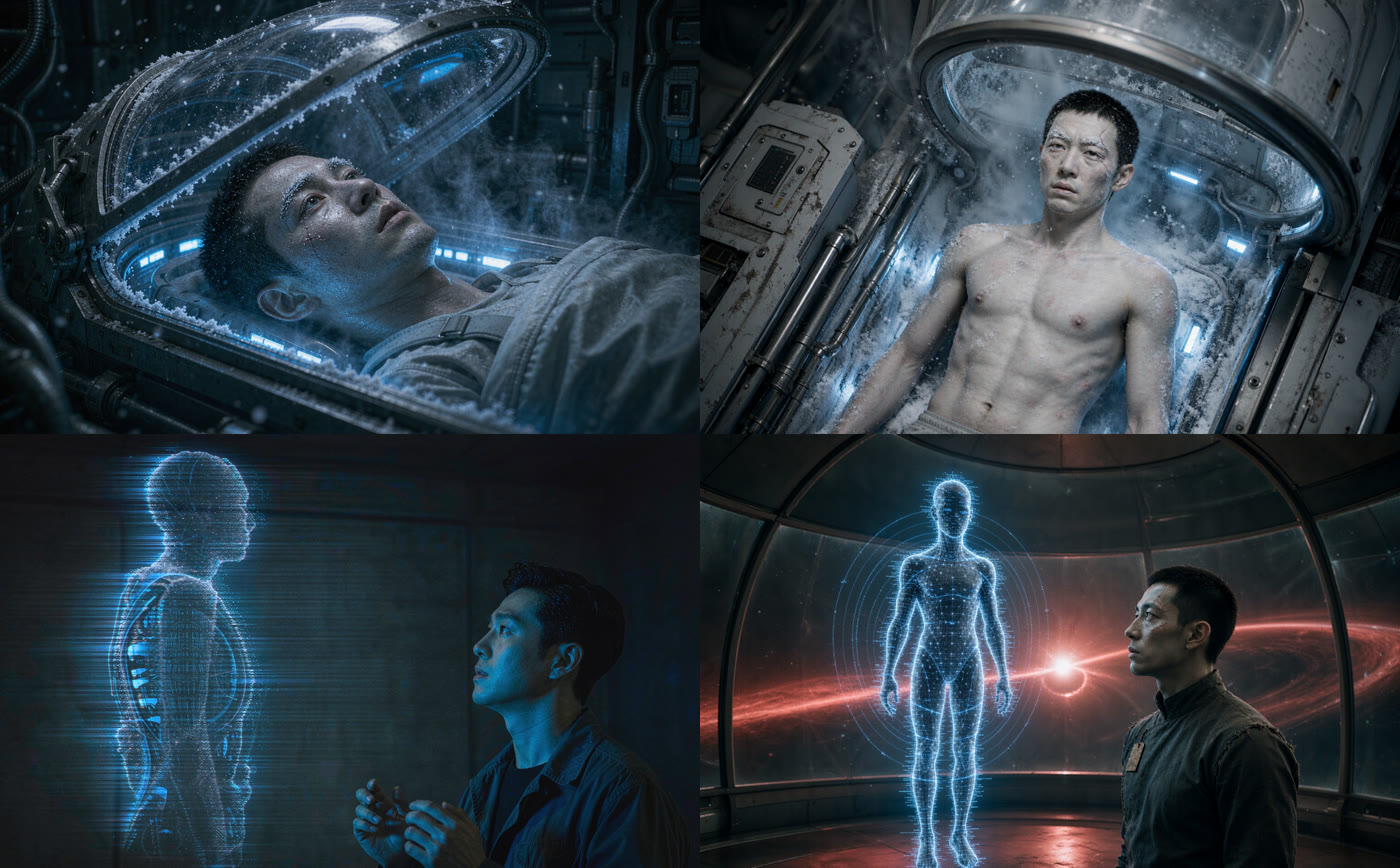
实拍对比:左列为改造前,右列为加 LUT + 重构图后——同一批素材,观感差一个档。
字幕走无底板 + 描边(底板是播放器 UI 不是电影字幕);颗粒在 RGB 域加(YUV 域加会染成品红)。
4. 渲染成片:浏览器写分镜,一键出 MP4
1 | |
- 分镜(story)支持视频片段(
kind:'clip'):lib/film-render.js用<video>逐帧定位画进画布,
文件不存在时自动退回静帧推拉——可渐进增强。 - 响度归一在编码前做(单遍 + 软限幅,目标 −16 LUFS)。不要在成片后跑 loudnorm——
那是 aac→aac 二次有损,且硬限幅会让归一失败;软限幅(tanh,阈值 −1 dBFS)无爆音、偏差 <0.01 LU。
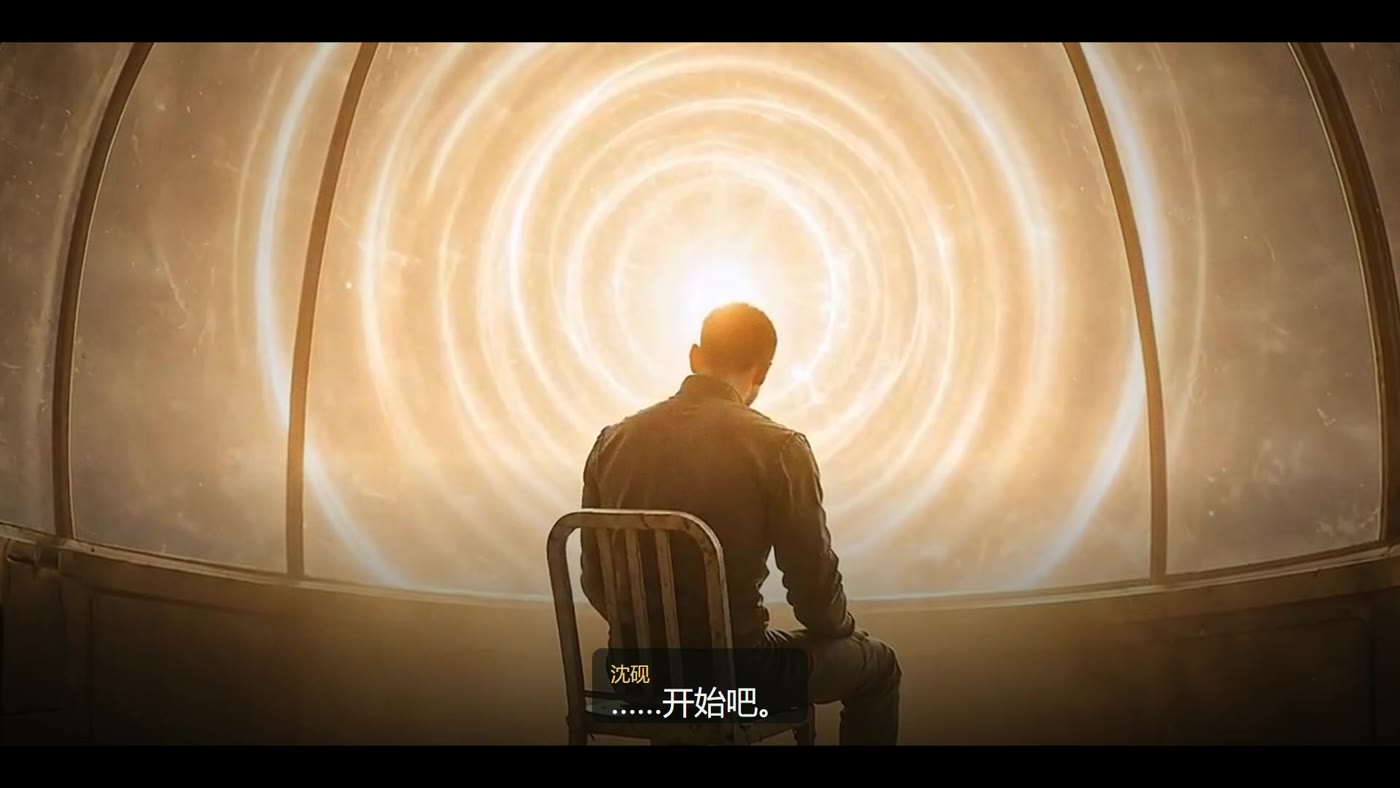
成片帧实拍:2.39:1 宽银幕遮幅、无底板描边字幕、角色名单独一行——这才是「电影字幕」而不是播放器 UI。
5. 资产链:多镜头角色一致
lib/asset-chain.js 驱动 stories/<slug>.assets.json:角色 base.lock 锁脸 + 场景 + 道具 + 镜头 schema,
保证同一角色跨镜头脸不变、光影统一。ImageGen 出图强制带水印,统一 clean-watermark.js 清(图片右下角 / 视频左上角处理不同,别混用)。
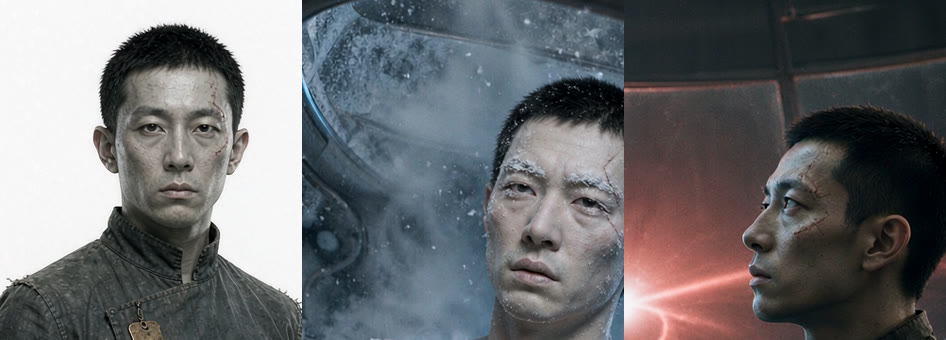
同一张脸在三个镜头/三种光下的实拍:锁脸 + schema 保证换镜不换人,这是多镜头故事能成立的前提。
三、技术实战:从脚本到成片
光看功能没感觉,下面用仓库里真实存在的故事文件 stories/night-3001.json(《第 3001 次日出》)走一遍。
实测环境:Windows 11 · RTX 4060 Laptop(8GB 显存)· Python 3.11 · Node 22 · 全部本地运行。
场景 A:把已有故事改造成电影(电影化管线)
最省事的一键入口,顺序由编排器保证,不会漏步也不会反步:
1 | |
想看清每一步产物、或只跑部分维度,就拆开手动跑(--all 会在此基础上按需插入慢动作):
1 | |
实测结果:14 个镜头 → 68 个镜头,平均镜头时长 17.6 秒 → 3.52 秒,片子的呼吸感一下就对了。--dim 可只勾部分维度(如 --dim 1,3 只做调色+慢动作),--steps grade,slowmo --factor 2 单独控慢放倍率。
场景 B:让角色开口说话(数字人)
1 | |
默认走 SadTalker(质量优先,会眨眼点头);加 --quality fast 切 Wav2Lip(只换嘴,约 13 秒/5 秒台词,适合远景)。
已有配音就直接喂 --audio xxx.wav,省一次 TTS。出来的 say.mp4 当插入镜头塞进上面的分镜即可。
场景 C:不想敲命令?可视化一站式
1 | |
浏览器里写分镜、勾电影化维度、点渲染,全程不用碰终端;/cinema-pack.html 是电影化套餐的勾选界面。
实战要点:慢动作必须先
setpts定时长、再minterpolate补帧——顺序反了 mci 模式会丢帧(2 倍慢放实测只到 1.45 倍还吃掉 1.4 秒画面);响度归一交给渲染层在编码前做,别成片后再 loudnorm。
四、关键结论(踩完一遍的硬货)
本地有两个免费引擎,定位不同,不是替代关系。 SadTalker 是本地免费里最像真人的一档(会眨眼会点头);
Wav2Lip 只换嘴、头眼身背景全冻结。选型靠--quality,不是靠调参。「太假」的根因通常是引擎选错,不是参数没调好。 Wav2Lip 的架构决定了它只换嘴,这部分怎么调都改不了;
要头部微动/眨眼必须用 SadTalker。别再靠调参去救 Wav2Lip。GFPGAN 增强强度要手动权衡。 官方硬编码
weight=0.5偏蜡光塑料感;打补丁改成读环境变量,0.35 是实测平衡点,
0.5+ 在脏污/暗光场景会明显失真。电影感是结构问题,不是滤镜问题。 17 秒一个不动的镜头,LUT 调再好也是 PPT。先切镜头(3~7 秒/镜)、加插入特写、用硬切,再谈调色。
响度归一必须在渲染期做。 成片后 loudnorm 是二次有损;正确做法是目标响度交给渲染层,在编码前的浮点 PCM 上做单遍 + 软限幅。
i2v 动态化让「幻灯片」变「电影」。 管线本就支持视频片段,火/雾/烟这类素材慢放是加分,人物动作镜头慎用;送进渲染的素材必须是 SAR 1:1 方像素,否则横向拉伸还静默出画。
绿幕 1:1 克隆本地无解,必须上云。 HeyGen 国外本机连不通;国内可达的是火山引擎即梦、腾讯智影、BigModel。本地方案只能到「照片说话」,到不了「1:1 分身」。
网络现实要先认。
github.com/huggingface.co被墙;装引擎走ghfast.top源码镜像、hf-mirror.com权重、pip 走pypi.tuna、torch 走官方源。setup 脚本已把镜像写进候选列表,且装 torch 生态必须用 Python 3.11(系统默认 3.13 不行)。
五、什么时候该用它
- ✅ 想做本地免费的 AI 短片 / 口播 / 科普视频,不想被按秒计费绑架。
- ✅ 需要角色跨镜头一致 + 可复用的电影化工具链,而非一次性生成。
- ❌ 想要1:1 真人分身克隆 → 本地做不到,直接上即梦/智影/HeyGen。
- ❌ 想要照片说话的顶级效果(带头部微动)→ 云端即梦 OmniHuman 仍是首选(约 1 元/秒)。
六、获取源码
夸克网盘提供两个版本,按需下载(失效就换备用地址):
| 版本 | 链接 | 提取码 |
|---|---|---|
完整版 libtv-free-full.zip(1.78 GB,含模型权重,解压即用) |
https://pan.quark.cn/s/0cf70e73aaed | mxa1 |
源码版 libtv-free-src.zip(仅源码与脚本,需自行装引擎) |
https://pan.quark.cn/s/0fd0c7dd4704 | 1X2k |
| 源码版 · 备用地址 | https://pan.quark.cn/s/d8174aef2ae8 | ydyn |
完整版解压即用,直接起服务:
1 | |
源码版要先装依赖与两个引擎(一次性,国内走镜像):
1 | |
国内网络现实:
github.com/huggingface.co被墙,源码与权重走ghfast.top/hf-mirror.com镜像,setup 脚本已内置候选列表;装 torch 生态必须用 Python 3.11(系统默认 3.13 不行)。
本文基于 LibTV Free 项目实测整理,命令与文件名均取自仓库真实脚本;下载地址若失效,留言即可补。